どうも!筋肉系AIエンジニアの國田です。
みなさん、RAGは好きですか?
え?なになに?「RAGってなんだ?お前のことだから、また筋トレ関係のワードか?」ですって...?
いえいえ、残念ながら筋トレとは関係ないです。ちなみに、私も今朝もジムでバーベルスクワットしてきたばかりです。
RAGとは、"Retrieval-Augmented Generation"の略で、生成AIが外部のデータベースや社内文書などから必要な情報を検索・取得し、その情報をもとに生成AIに回答を作成させる仕組みを指します。
つまり、社内文書などに関する質問をAIに答えさせるために、AIの裏側に検索取得を持つ仕組みのことですね。
当ブログでは、不定期にこのRAGに関する検証記事を扱っていますが、最近では、以下の記事のように「AIエージェントに検索を委ねる」手法が注目されています。
元来、RAGの手法では、参照するべきデータを全てベクトル化してデータベースに保存しておき、ベクトルを元に類似度計算で回答を検索する手法がよく使われていました。
ただ、AIエージェントによる文書検索を使えば、そもそもデータをベクトル化することなく必要な情報を検索することが可能です。
とは言いつつも、実際にはAIエージェントが検索可能なようにデータ全体を整備する必要があるため、人間側で、事前に検索空間を用意しておく必要があります。
例えば、プロテインの商品データがあった場合には、以下のようにフォルダを構成しておき、AIエージェントがフォルダ全体を俯瞰した際に、どこにどんなデータがあるのか、回答に必要なデータの在処はどこかといった情報が分かるようにセッティングしておくと検索精度の向上に役立ちます。
(クリックで展開)
├── 種類
│ ├── ピー
│ ├── ホエイアイソレート
│ ├── 植物性ブレンド
│ ├── クリアホエイ
│ ├── ゲイナー
│ ├── ライス
│ ├── ホエイ
│ ├── カゼイン
│ ├── ソイ
│ └── 混合
├── 味
│ ├── 抹茶系
│ ├── コーヒー系
│ ├── その他
│ ├── 穀物系
│ │ └── シナモンオートミール系
│ ├── キャラメル系
│ ├── バニラ系
│ ├── チョコレート系
│ ├── 種実系
│ │ └── 黒ごま系
│ ├── ココア系
│ ├── 果物系
│ │ ├── バナナ系
│ │ ├── ベリー系
│ │ ├── マンゴー系
│ │ ├── 柑橘系
│ │ └── 桃系
│ ├── プレーン
│ └── 大豆系
│ └── きなこ系
├── 体質・食事制限
│ ├── カフェイン
│ │ ├── カフェインあり
│ │ ├── カフェインなし
│ │ └── カフェイン少量
│ ├── アレルゲン
│ │ ├── 大豆
│ │ ├── 米
│ │ ├── オーツ麦
│ │ ├── えんどう豆
│ │ ├── 乳成分
│ │ └── なし
│ ├── 乳糖
│ │ ├── 乳糖不使用
│ │ └── 乳糖不使用ではない
│ └── 植物性
│ ├── いいえ
│ └── はい
├── 原材料由来
│ ├── 米由来
│ ├── その他
│ ├── えんどう豆由来
│ ├── 植物性ブレンド
│ ├── 大豆由来
│ └── 乳由来
├── 食数_1袋あたり
│ ├── 20食以上30食未満
│ ├── 30食
│ └── 31食以上
├── 栄養成分_1食あたり
│ ├── タンパク質量
│ │ ├── 20g以上25g未満
│ │ └── 25g以上30g未満
│ ├── 糖質
│ │ ├── 1g未満
│ │ ├── 1g以上3g未満
│ │ ├── 3g以上5g未満
│ │ └── 5g以上
│ ├── 脂質
│ │ ├── 1g未満
│ │ ├── 1g以上2g未満
│ │ ├── 2g以上4g未満
│ │ └── 4g以上
│ ├── タンパク質含有率
│ │ ├── 70パーセント未満
│ │ ├── 70パーセント以上80パーセント未満
│ │ ├── 80パーセント以上90パーセント未満
│ │ └── 90パーセント以上
│ └── カロリー
│ ├── 120kcal未満
│ ├── 120kcal以上140kcal未満
│ ├── 140kcal以上180kcal未満
│ └── 180kcal以上
└── 価格_1袋あたり
├── 3000円未満
├── 3000円以上4000円未満
├── 4000円以上5000円未満
└── 5000円以上
ただ、この作業、「意外と泥臭くて、面倒くさい」んですよね。
私もAIエージェントの検証作業のためによくやるのですが、もう面倒で本当にやりたくない。
着手しようと思ってもなかなか気が重く、いつも気がつくと、背後のパワーラックでバーベルスクワットに逃げています。
昨今、AIによる作業の代替が叫ばれる中、「こういった作業ももう少しAIで補助できないものか?」と考えてしまうのは不自然ではないでしょう。
私だって、こういったことはなるべく楽をしたいんです。
検索空間(インデックス)だってAIエージェントに作ってもらったっていいじゃないか!
ということで、今回はベクトルを利用しないAgentic Searchにおいて、検索インデックスそのものをAIエージェントに作らせてみたいと思います。
「AIエージェント自身がファイルを探せるなら、わざわざインデックスなんて作らなくてもいいのでは?」と思う方もいるかもしれません。
確かに、小規模なデータであれば、キーワードサーチや総当たりで十分に検索できるでしょう。
ただし、これが1000件、1万件と増えていけば話は変わります。AIエージェントが毎回大量のファイルを確認すれば、その分だけ読み込むデータ量も増えます。当然、入力される文字数も増えますし、検索に必要なステップ数や処理時間にも影響します。
そこで、「この質問なら、まずこの範囲を探せばよい」という検索用の道標を用意しておくことで、検索過程そのものの効率化を図るわけです。検索範囲を小さくできれば、時間だけでなく、コスト的なメリットもあります。
何より人間が「どのインデックスを元に回答したのか?」を後追い・確認できる点は、ベクトル検索と比較してもメリットが非常に大きいです。
さぁ、やってみよう
今回は、以前の記事でも使用した25種類のプロテインデータを使います。
P001_朝霧ホエイ_チョコレート.md
P002_朝霧ホエイ_バニラ.md
P003_抹茶静寂アイソレート.md
P004_透明柑橘クリア.md
P005_黒ごま大豆プロテイン.md
P006_きなこ大豆ライト.md
P007_完熟バナナゲイナー.md
P008_焦がしキャラメルゲイナー.md
P009_夜凪カゼイン_ココア.md
P010_眠りのミルクカゼイン.md
P011_青豆ピープロテイン.md
P012_玄米ナチュラルプロテイン.md
P013_珈琲集中ホエイ.md
P014_抹茶集中ホエイ.md
P015_苺ヨーグルトホエイ.md
P016_白桃クリアホエイ.md
P017_塩バニラミネラル.md
P018_蜂蜜レモンリカバリー.md
P019_無糖プレーンアイソレート.md
P020_低価格チョコスタンダード.md
P021_大容量バニラスタンダード.md
P022_高タンパク質チョコアイソレート.md
P023_シナモンオートミールプロテイン.md
P024_南国マンゴークリア.md
P025_ミックスベリービーガン.md
各プロテインには、
- 価格
- 味
- タンパク質量
- 脂質
- 糖質
- プロテインの種類
- 溶けやすさ
- おいしさ
など、複数の情報が含まれています。
以前は、これらのデータから私自身が検索用のインデックスを作成しましたが、今回は「インデックスを構築するAIエージェント」を準備し、作業そのものをAIに任せてみたいと思います。
AIにやらせるタスクとしては、以下の手順です。
-
マスターデータ全体を読み込み、データの構造を把握する
-
ユーザーからの質問を想定し、どのような観点で検索されるかを考える
-
AIエージェントが探索しやすい索引(インデックス)構造を設計する
-
実際にインデックスフォルダおよびファイルを生成する
このようにして完成したインデックスを、検索・回答用のAIエージェントへ渡し、事前に用意した質問に対して回答できるかを確認したいと思います。
なお、検索・回答用のエージェントは「インデックス(フォルダ名とファイル名)の取得・閲覧」および「ユーザーの質問から連想するキーワード検索」の2つの結果を元に、マスターデータのファイルを閲覧した上で回答を生成する仕組みです。
結果
まず、今回の実験でAIエージェントが作成したインデックスを以下に示します。
(クリックで展開)
├── 種類
│ ├── ホエイ.md
│ ├── ピー.md
│ ├── クリアホエイ.md
│ ├── 混合.md
│ ├── ホエイアイソレート.md
│ ├── ソイ.md
│ ├── ライス.md
│ ├── カゼイン.md
│ ├── 植物性ブレンド.md
│ └── ゲイナー.md
├── 価格
│ ├── 3500円未満.md
│ ├── 3500円以上4500円未満.md
│ └── 4500円以上.md
├── 栄養条件
│ ├── 低カロリー_1食あたり120kcal以下.md
│ ├── 低糖質_1食あたり2.0g以下.md
│ └── 高タンパク質_1食あたり25g以上.md
├── 利用条件
│ ├── 植物性.md
│ ├── 乳糖不使用.md
│ ├── カフェインあり.md
│ └── カフェインなし.md
├── 利用目的
│ ├── 初心者適性_4以上.md
│ ├── 夜向け適性_4以上.md
│ ├── 増量適性_4以上.md
│ ├── リカバリー適性_4以上.md
│ └── ダイエット適性_4以上.md
ちなみに、各.mdファイルの中身ですが、大元の参照すべきファイルのリストが記載されています。
例えば、`価格/3500円未満.md`の中身は以下です。
- data/P005_黒ごま大豆プロテイン.md
- data/P006_きなこ大豆ライト.md
- data/P020_低価格チョコスタンダード.md
ここで、`data/P005_黒胡麻大豆プロテイン.md`などは、大元のデータセットの格納先のパスを示しています。
つまり、単に「3,500円以下のプロテインを探したい」場合には、上記3つをそのまま提示すれば良いですし、「3,500円以下のソイプロテイン」のような複合条件の場合には、他のインデックスも並行して見たり、直接マスターデータセットのファイルの中身を確認しに行くことで、回答を生成すれば良いわけですね。
では、実際にいくつか質問をして、AIエージェントがきちんと回答を生成できるか確認してみましょう。
Q. 低糖質でタンパク質が多いものを探している
想定している答えは、「P022_高タンパク質チョコアイソレート.md」と「P019_無糖プレーンアイソレート.md」です。
実際の回答は以下のようになりました。
ご希望条件「低糖質でタンパク質多め」に合うものは、この3つです。違いがわかるように整理します。

---


1. 無糖プレーンアイソレート(P019)

成分重視なら一番おすすめ


- タンパク質:28g(含有率90%)

- 糖質:0.6g(今回の中で最少)

- 脂質:0.4g

- カロリー:109kcal

- 味:プレーン(無糖)

- ダイエット適性:5 / 5

- 推薦メモ:味付けなしで高タンパク。おいしさより成分重視の人向け。


向いている人

- とにかく糖質を最小限にしたい

- 味より成分・数値を優先したい


---


2. 高タンパク質チョコアイソレート(P022)

チョコ味で飲みやすく、タンパク質量も最も多い


- タンパク質:29g(含有率91%:今回で最高)

- 糖質:0.9g

- 脂質:0.5g

- カロリー:114kcal

- 味:チョコレート(甘さ控えめ)

- ダイエット適性:5 / 5

- おいしさ:4 / 5

- 溶けやすさ:5 / 5

- 推薦メモ:高タンパク質かつ低糖質。チョコ味としては甘さ控えめ。


向いている人

- 飲みやすさも重視したい

- チョコ味が好きで、砂糖控えめなものを選びたい


---


3. 抹茶静寂アイソレート(P003)

抹茶好きならこれ


- タンパク質:27g(含有率86%)

- 糖質:1.1g

- 脂質:0.6g

- カロリー:113kcal

- 味:抹茶(甘さ控えめで苦味あり)

- ダイエット適性:5 / 5

- おいしさ:4 / 5

- カフェイン:少量

- 推薦メモ:甘さ控えめで抹茶の苦味がある。高タンパクかつ低糖質を重視する人向け。


向いている人

- 抹茶の苦味が好き

- 甘さ控えめのフレーバーを試したい


---


まとめ


- 数値最優先(糖質最小)なら:P019 無糖プレーンアイソレート

- 味と成分のバランス(タンパク質量も最大)なら:P022 高タンパク質チョコアイソレート

- 抹茶好き・甘さ控えめなら:P003 抹茶静寂アイソレート


味の好みがあれば教えていただければ、この中からさらに絞り込みます。
きちんと正解を提示できているようです。
これは、以下の2つのインデックスを参照し、導出された答えです。
低糖質と高タンパクの2つのインデックスを参照し、共通項を取り出していますね。分かりやすい!
次の質問にいってみましょう。
Q. お腹がゴロゴロしにくいプロテインが欲しい。でも、価格は抑えたいです。
これは、なかなかマニアックな質問ですよね?
一部の乳由来プロテインには、乳糖が含まれます。乳糖をうまく消化しにくい人の場合、乳製品を摂ったあとにお腹の張り、ガス、下痢、腹痛などが起きることがあります。
そのような方は、乳糖が少ない、または乳糖不使用の製品が候補になります。プロテインであれば、ホエイアイソレートや、乳由来ではないソイプロテインなどが選択肢になります。
ただし、ホエイアイソレートは価格が高めになりやすい傾向があります。
つまり
お腹がゴロゴロしにくい = 乳糖不使用、または乳由来ではないもの
価格を抑えたい = ホエイよりもソイプロテイン
を特定する必要があります。インデックスとしては、「乳糖不使用」も「ソイ」もいずれも用意されていますが、うまくいくでしょうか?
条件に合う中で、まずおすすめできる順にお伝えします。


---


第1候補:きなこ大豆ライト(P006)


- 種類:ソイ(植物性)

- 乳糖不使用:はい

- 価格:3280円 / 30食(1食あたり約109円)

- タンパク質:20g(含有率70%)

- 特徴

  - 植物性&乳糖不使用なので、乳由来の成分が気になる方に選ばれやすいタイプです。

  - ダイエット適性「5 / 5」、夜向け適性「5 / 5」で、置き換えや就寝前にも使いやすいとされています。

  - 甘さ控えめのきなこ味で、おいしさ評価「4 / 5」。


こんな方に

- お腹への負担をできるだけ抑えたい

- 夜の置き換えにも使いたい

- 和風・きなこ味が好き


---


第2候補:黒ごま大豆プロテイン(P005)


- 種類:ソイ(植物性)

- 乳糖不使用:はい

- 価格:3480円 / 30食(1食あたり約116円)

- タンパク質:21g(含有率72%)

- 特徴

  - 植物性&乳糖不使用で、性質はP006に近いです。

  - ダイエット適性「4 / 5」、夜向け適性「5 / 5」。

  - 香ばしい黒ごま味で、おいしさ評価「4 / 5」。

  - 推薦メモに「水では少しざらつきが出やすい」とあるので、気になる場合は牛乳や豆乳で割る飲み方が好まれやすいかもしれません。


こんな方に

- 黒ごまの香ばしい風味が好き

- 植物性&乳糖不使用を重視しつつ、やや高くてもOK


---


第3候補:低価格チョコスタンダード(P020)


- 種類:ホエイ

- 乳糖不使用:いいえ

- 価格:2980円 / 30食(1食あたり約99円)

→ この3つの中では最安

- タンパク質:21g(含有率70%)

- 特徴

  - 「価格を抑えたチョコ味。成分や溶けやすさは標準的。」とある通り、コスパ重視のホエイプロテインです。

  - 初心者適性「4 / 5」で、ホエイを試したい方には入りやすいタイプです。

  - ただし属性上「乳糖不使用:いいえ」なので、乳由来成分を避けたい方には向きにくい可能性があります。


こんな方に

- とにかく価格を抑えたい

- チョコ味のスタンダードなホエイを試したい

- 乳成分を特に気にしていない


---


まとめ


- お腹のゴロゴロをなるべく避けたい+価格も抑えたいなら

  「きなこ大豆ライト(P006)」を第一候補としておすすめします。

  植物性・乳糖不使用で、価格も3製品の中では中間ですが、ダイエット・夜向けの評価が高く、バランスが良いです。


- 和風より香ばしい黒ごまが好きなら

  少しだけ高価になりますが、「黒ごま大豆プロテイン(P005)」。


- 最安を最優先し、乳成分も気にならないなら

  「低価格チョコスタンダード(P020)」が一番安く、ホエイを試したい場合に向いています。


味の好み(きなこ・黒ごま・チョコ)、飲むタイミング(夜中心かどうか)、予算感などを教えていただければ、この3つの中からさらに絞り込みもできます。
良いですね、第一、第二候補は、きちんとソイプロテインを提示しています。
第三候補として出しているのは、実際には乳糖の含まれたプロテインですので、質問に対する答えとしては、厳密に言ってしまうと不適切です。ただし、【属性上「乳糖不使用:いいえ」なので、乳由来成分を避けたい方には向きにくい可能性があります。】と回答中に記載してあるので、完全にNGというわけではないです。
(そのあたりは検索性能とは別に回答性能のコントロールが必要かも知れませんね。)
さて、別の問いもやってみましょう。
Q. おいしくて水に溶けやすいチョコ系が欲しい
想定している答えは、「P001_朝霧ホエイチョコレート.md」もしくは「P022_高タンパク質チョコアイソレート.md」ですが、実は、この質問に対しては、対応するインデックスがあらかじめ構築できていません。
AIエージェントが作成したインデックスを見ると、「美味しさ」「溶けやすさ」「味」といったカテゴリは配置していません。果たして、この条件で実際に取得はできるのでしょうか?
実際の答えは、
条件だと、いちばんおすすめはこれです。


第一候補:朝霧ホエイ チョコレート(P001)


おすすめ理由(製品情報より)

- おいしさ評価:5 / 5

- 溶けやすさ評価:5 / 5

- 推薦メモに「水でも粉っぽさが少ない」と記載あり

- 甘めのチョコ味で、牛乳とも相性がよいとされている


「おいしくて水に溶けやすいチョコ系」という希望には、これがいちばん合っています。


---


甘さ控えめが好きなら:高タンパク質チョコアイソレート(P022)


こちらもチョコ味で溶けやすさ評価 5 / 5 ですが、

- おいしさ評価:4 / 5

- 推薦メモに「チョコ味としては甘さ控えめ」と記載


甘さを抑えた味が好みなら、こちらのチョコも候補になります。


まずは「朝霧ホエイ チョコレート」を試してみて、甘さが強いと感じたら次に「高タンパク質チョコアイソレート」を検討してみるのがおすすめです。
...できてしまいましたね。
インデックスがないのにかかわらず、なぜ取得できたのでしょうか?
実は、その答えは商品名にありました。
今回のテストでは、AIエージェント自体にファイルの検索を任せて動かしているのですが、ファイル名に「チョコ」が含まれているものをAIエージェントがピックアップしていたようでした。
本来の設計意図は、「インデックスからの検索」(≒ フォルダ名を参考に探す)なのですが、ファイル名をヒントに正解にまで辿り着けたという(幸運な?)例になりますね。
では、さらに意地悪な問いをしてみましょう。
絶対にインデックスにもファイル名でもわからない質問をしてみます。
Q. 脂質の少ないプロテインは?
わかりません。
はい、予想通り、答えられませんでした!
商品名にも一切ヒントのない質問のため、AIエージェントもどのファイルを閲覧しにいけば良いか分かりません。
ということで、AIエージェントにインデックスを作らせる方法では網羅的なインデックスの構築はできず、全ての質問に答えられない。やはり人間が構築するしかない!
以上が結論です。
...
......
............
........................
................................................はい。
流石に批判を受けそうですので、ちゃんと対応します。
上記のようなケースでは、既存のインデックスに新しい検索軸を追加する必要があります。
インデックスを作成したAIエージェントに対し、継続作業として、
「既存のインデックスを残したまま、新しい検索軸を追加できるか?」を命令してみます。
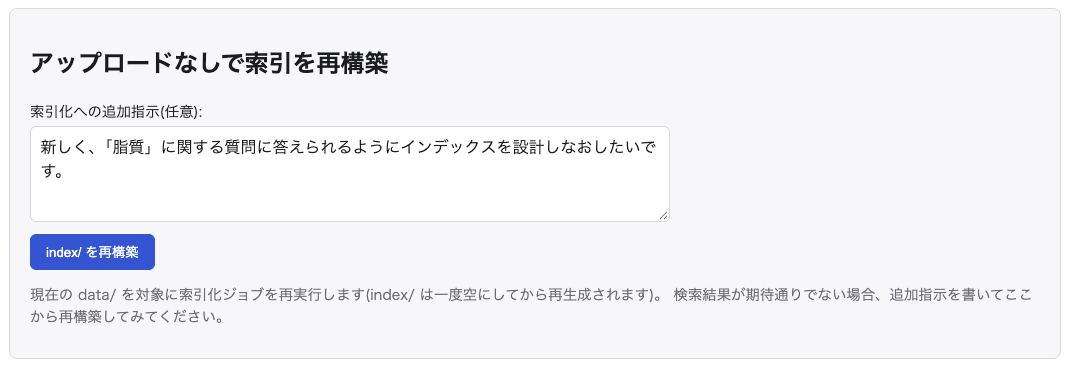
たとえば、「新しく『脂質』に関する質問に答えられるように、既存のインデックスを拡張してください」と指示してみると・・
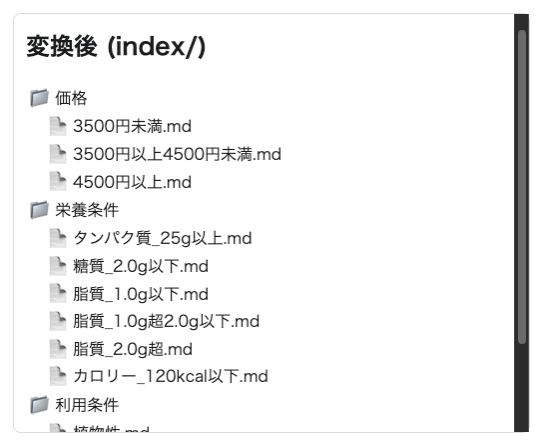
├── 栄養条件
│ ├── タンパク質_25g以上.md
│ ├── 糖質_2.0g以下.md
│ ├── 脂質_1.0g以下.md
│ ├── 脂質_1.0g超2.0g以下.md
│ ├── 脂質_2.0g超.md
│ └── カロリー_120kcal以下.md
上記のように、AIエージェントは既存のインデックス構造を確認しながら、元データを参照し、新しい検索軸を追加することができました。
元々、「栄養条件」というフォルダ名(インデックス)はあったのですが、その中身は「タンパク質」「糖質」「カロリー」のみでした。そこに新しく「脂質」が加えられた形になります。
ただ、このままではまだ少しおかしいですよね?
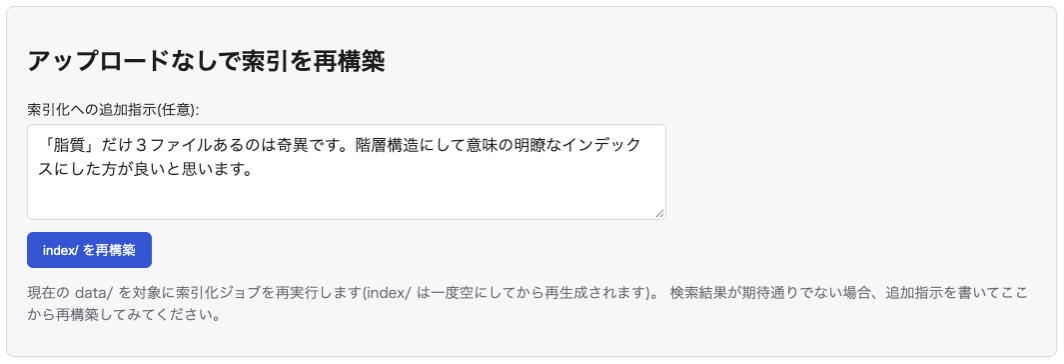
具体定には、「タンパク質」「糖質」「カロリー」がそれぞれ1ファイルのみであるのにかかわらず、脂質だけが3ファイルあり、フォルダの構造としても少し歪な感じがします。
なので、AIエージェントに対して、「脂質だけ3ファイルあるのはおかしい。ここはディレクトリ構造にするべきだ」と指摘し、修正指示を出します。
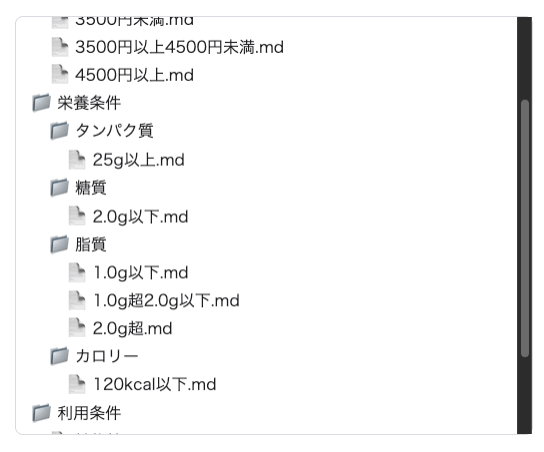
├── 価格
│ ├── 3500円未満.md
│ ├── 3500円以上4500円未満.md
│ └── 4500円以上.md
├── 栄養条件
│ ├── タンパク質
│ │ └── 25g以上.md
│ ├── 糖質
│ │ └── 2.0g以下.md
│ ├── 脂質
│ │ ├── 1.0g以下.md
│ │ ├── 1.0g超2.0g以下.md
│ │ └── 2.0g超.md
│ └── カロリー
│ └── 120kcal以下.md
├── 利用条件
│ ├── 植物性.md
すると上記のように、栄養条件の直下に各栄養素やカロリーのフォルダが追加され、その下にファイルを配置する構造に変わりましたね。
(この時点では、「タンパク質の少ないプロテイン」や「糖質の多いプロテイン」はインデックス内に網羅はされてはいません。ただ、今後指示すれば追加できる余地ができました。)
このように人間の命令だけでインデックス構築を自由に改良・改善をしてくれるのがこの手法の面白い点ですね。
さて、話を戻しましょう。
この新しいインデックスのできた条件下で、改めて脂質に関する質問をAIエージェントに投げてみます。
Q. 脂質の少ないプロテインは?
脂質が少ないものだと、以下3つが特におすすめです。


1. 南国マンゴークリア(P024)

- 脂質:0.2g(今回の候補の中で最少)

- タンパク質:21g、ダイエット適性:5 / 5

- 果物系で後味が軽く、夏場や運動直後に飲みやすいクリアホエイです。

→「脂質をできるだけ削りたい」「さっぱり飲みたい」なら一番候補です。


2. 無糖プレーンアイソレート(P019)

- 脂質:0.4g

- タンパク質:28g、タンパク質含有率:90%、ダイエット適性:5 / 5

- 味付けなしで高タンパク。成分重視の人向けのホエイアイソレートです。

→「味より成分」「糖質も脂質も低くしたい」人に向いています。


3. 高タンパク質チョコアイソレート(P022)

- 脂質:0.5g

- タンパク質:29g、タンパク質含有率:91%、ダイエット適性:5 / 5

- 高タンパク・低糖質で、チョコ味としては甘さ控えめ。

→「チョコ味でおいしさも欲しい」「脂質を抑えつつタンパク質をしっかり摂りたい」人向けです。


植物性がよければ、脂質1.6gですが

ミックスベリービーガン(P025)も候補になります(植物性・乳糖不使用、ダイエット適性5 / 5)。


味の好み(さっぱり系/プレーン/チョコ/植物性)を教えてもらえれば、さらに1つに絞っておすすめできます。
見事に回答できるようになりました。
面白いのは、AIに一度インデックスを作らせて終わりではなく、検索できなかった問いを起点に、人間が追加の指示を出しながら検索空間そのものを修正できたことですね。
最初から完璧なインデックスを人間が設計する必要もなく、まずAIにインデックスを作らせて、人間が実験してみてダメなら追加依頼をするというトライアンドエラーでインデックスの構築を進めることができます。
(これで、私もAgentic Searchの検証環境を作るたびに、延々とフォルダを掘る作業から少し解放されそうです(笑))
まとめ
いかがでしたか?
今回は、Agentic Search用のインデックスそのものをAIエージェントに構築させてみました。
AIだけでは、最初から完璧な検索空間ができるわけではありませんでした。ただ、その不足が分かった上で人間が意図を伝えることで、既存の構造を踏まえてインデックスを追加・修正できるようになりました。
人間が最初から検索空間をすべて設計するのではなく、AIにたたき台を作らせ、実際の検索結果を見ながら人間とAIで育てていくという形は、AI運用として理想的な形ではないでしょうか?
これで、私も検索インデックスを作るために延々とフォルダを掘る作業からは、解放されそうです。
え?「浮いた時間で何をするか?」って?
もちろん、バーベルスクワットです。
ではまた!
おまけ:対話用のUIも作ってみた
ちなみに、普段このような検証はPythonスクリプトだけで済ませることが多いのですが、今回はせっかくなので、インデックスの生成・更新を対話形式で操作できる簡単なUIも作ってみました。
最近流行りのコーディングエージェントに作らせたものですが、中々便利ですね。
あんまり開発工程寄りの話は、当ブログではしないのですが、昨今のバイブコーディングの流行も考えると、「ゴリゴリの開発の話を入れても面白いのかも?」と思う今日この頃です。